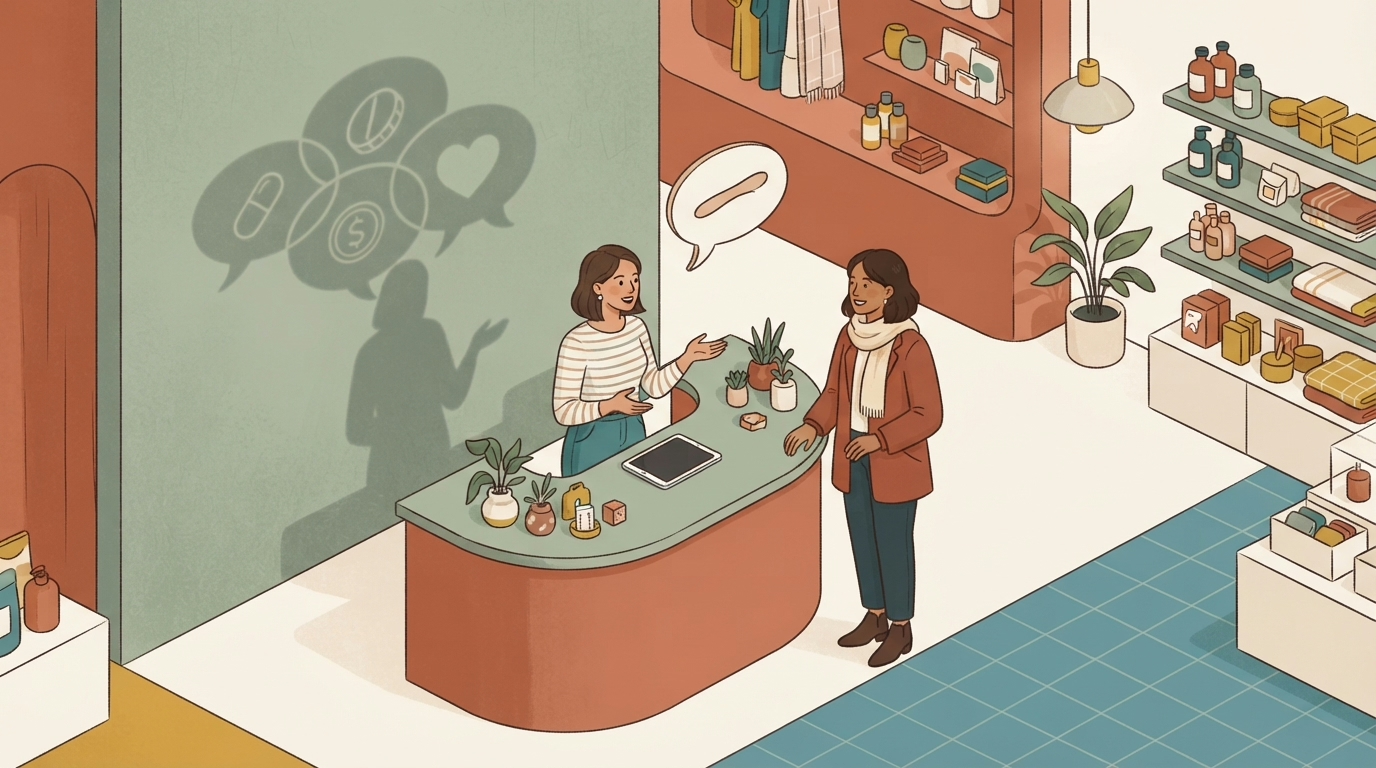
Un client écrit à votre chatbot qu’il cherche une crème « sans parfum, à cause de mon traitement ». Un autre demande s’il peut payer en quatre fois « parce que décembre est serré ». Aucun des deux n’a rempli de formulaire sur sa santé ou ses finances. La conversation en dit déjà long. Un modèle de langage sait tirer ces déductions en une fraction de seconde.
Ces informations déduites s’appellent des inférences. Le rapport « Protéger sans empêcher », remis au président de la République le 10 novembre 2026, en fait l’un de ses sujets : une conversation suffit à deviner un état de santé, une opinion ou des difficultés financières. Bonne nouvelle pour les marques prudentes : le droit européen protège déjà une partie de ces déductions. Voici comment les repérer dans votre chatbot, ce que la jurisprudence en dit et les réglages à faire avant que vos transcriptions ne nourrissent votre CRM.
Comment un chatbot déduit ce que le client n’a pas dit
Un modèle de langage est entraîné à comprendre le contexte. Cette capacité le rend utile pour conseiller un produit. Elle lui permet aussi de relier des indices dispersés. Trois mécanismes produisent des inférences dans un chatbot de marque.
COMPARATIF
Trois sources d'inférences dans un chatbot de marque
Chaque mécanisme appelle un réglage différent.
Critères comparés : Origine de la déduction, exemple, endroit où elle est stockée.
La réponse elle-même
Recommandé pour : Les équipes qui personnalisent fortement les réponses
- Le modèle adapte son conseil à un indice de santé ou de budget.
- Exemple : il oriente vers des produits « adaptés aux peaux sous traitement ».
- Stockage : l’historique de la conversation.
Le résumé de conversation
Recommandé pour : Les équipes qui transfèrent les échanges au service client ou au CRM
- Un résumé automatique formule la déduction en clair.
- Exemple : « cliente enceinte, cherche des soins compatibles ».
- Stockage : la fiche client, souvent sans limite de durée.
La segmentation
Recommandé pour : Les équipes qui ciblent leurs campagnes à partir des échanges
- Un outil classe les clients à partir de leurs conversations.
- Exemple : un segment « budget serré » nourri par les demandes de paiement fractionné.
- Stockage : les audiences publicitaires et les listes d’e-mailing.
Le deuxième et le troisième cas sont les plus exposés. Un résumé ou un segment persiste et circule entre vos outils : la déduction quitte la conversation pour devenir une donnée client.
Ce que le droit protège déjà
L’article 9 du RGPD et les données qui « révèlent »
L’article 9 du RGPD interdit par principe le traitement de catégories particulières de données : origine raciale ou ethnique, opinions politiques, convictions religieuses ou philosophiques, appartenance syndicale, données génétiques et biométriques, données de santé, vie ou orientation sexuelle. Des exceptions existent, la principale pour une marque étant le consentement explicite.
Dans son arrêt du 4 juillet 2023 (Meta Platforms, affaire C-252/21), la Cour de justice de l’Union européenne a jugé que ce régime s’applique aussi à des données qui permettent de révéler indirectement de telles informations, par exemple la consultation de sites ou d’applications liés à ces catégories. Peu importe que l’information soit exacte, et peu importe que l’entreprise ait cherché à l’obtenir.
Transposé à un chatbot, ce raisonnement pourrait viser un résumé qui note « client diabétique » à partir d’une question sur le sucre. L’application exacte dépendra des autorités et des juges. La prudence commande de traiter ces résumés comme des données sensibles.
Ce que propose le rapport remis à l’Élysée
Selon l’analyse publiée par le cabinet Kohen, la recommandation n° 17 du rapport propose d’obliger les fournisseurs d’IA conversationnelle à déclarer, dans leur politique de confidentialité, les catégories d’attributs qu’ils peuvent déduire. Toute exploitation commerciale de ces profils serait soumise aux garanties de l’article 9, avec une extension à la situation financière et à l’état mental ou émotionnel. Chaque utilisateur pourrait accéder à ces inférences, les contester et s’opposer à leur usage commercial.
Il s’agit d’une proposition, qui indique clairement la direction du débat français. Vos clients liront les mêmes articles de presse que vous.
Auditer votre chatbot en une après-midi
Le protocole d'audit des inférences
À mener avec la personne qui administre le chatbot et votre référent données personnelles.
-
Extraire un échantillon de conversations
Exportez des conversations récentes depuis votre outil de chatbot, en retirant noms, e-mails et numéros de commande.
Point de contrôle : L'échantillon couvre au moins une centaine d'échanges récents, pseudonymisés.
-
Repérer les indices sensibles
Cherchez les mots qui trahissent un état de santé, une contrainte budgétaire, une pratique religieuse ou une situation familiale. Le prompt ci-dessous accélère ce tri.
Point de contrôle : Chaque indice relevé est classé par catégorie : santé, finances, religion, opinions, vie privée.
-
Suivre le trajet de chaque donnée
Historique conservé chez l’éditeur, résumé envoyé au CRM, étiquette transmise à l’outil d’e-mailing : dessinez le circuit, outil par outil.
Point de contrôle : Vous savez où partent l'historique, le résumé et les étiquettes de chaque conversation.
-
Couper les flux inutiles
Modifiez la consigne des résumés pour exclure toute déduction sur la santé ou les finances, et désactivez les étiquettes automatiques fondées sur le contenu des conversations.
Point de contrôle : Aucune inférence sensible n'atteint le CRM ou les audiences publicitaires sans base légale identifiée.
-
Documenter et informer
Mettez à jour votre registre des traitements et votre politique de confidentialité. Si le chatbot traite des données sensibles à grande échelle, une analyse d’impact (AIPD) s’impose.
Point de contrôle : La politique de confidentialité décrit le traitement des conversations et leur durée de conservation.
PROMPT 1
Repérer les inférences sensibles dans un échantillon
Objectif : Classer les indices sensibles présents dans des conversations pseudonymisées, pour décider des flux à couper.
Vous êtes chargé d’un audit de protection des données. Voici un échantillon de conversations pseudonymisées entre des clients et le chatbot de notre marque : [coller l’échantillon]. Pour chaque conversation, indiquez si elle contient un indice permettant de déduire l’une des informations suivantes : santé, situation financière, religion, opinions politiques, orientation sexuelle, situation familiale. Citez le passage concerné, la catégorie et le niveau de certitude (faible, moyen, élevé). Ne formulez aucune déduction sur la personne elle-même : signalez uniquement le passage.
À vérifier : N'utilisez que des conversations pseudonymisées et un outil IA dont les conditions excluent l'entraînement sur vos données. Vérifiez manuellement chaque classement.
Régler le chatbot pour qu’il déduise moins
L’audit révèle le problème. Les réglages le réduisent. Ils tiennent pour la plupart en quelques lignes de consigne et en deux paramètres d’administration.
Minimiser les inférences : gains et coûts
Arbitrages à évaluer selon votre secteur et l'usage réel du chatbot.
Ce que vous gagnez
- Moins de données sensibles stockées, donc moins d’exposition en cas de fuite.
- Une politique de confidentialité plus simple à rédiger et à défendre.
- Des clients qui se confient sans craindre un ciblage ultérieur.
Ce que vous acceptez
- Des conseils un peu moins personnalisés dans certains secteurs (santé, beauté, crédit).
- Des résumés moins riches pour le service client.
- Un travail de reformulation des consignes et des tests réguliers.
Concrètement, trois réglages font l’essentiel du travail. Une consigne système qui interdit au chatbot de formuler toute hypothèse sur la santé, les finances ou les convictions du client. Une consigne de résumé limitée aux faits utiles au traitement de la demande (produit, commande, problème). Une durée de conservation courte pour les historiques bruts, alignée sur le besoin réel du service client.
Si votre chatbot est connecté à d’autres systèmes, les dix règles de sécurité pour les agents IA reliés au CRM complètent ce dispositif. Pour le cadre de transparence vis-à-vis du client, notre guide sur la mention des contenus générés par IA rappelle les obligations d’information en vigueur.
Mot de la fin
Un chatbot de marque recueille des confidences que vos formulaires n’obtiendront jamais. Cette richesse a un prix : chaque déduction stockée devient une donnée dont vous répondez. Lancez l’audit avant le pic de conversations de décembre, coupez les flux d’inférences vers le CRM et les audiences, puis réécrivez vos consignes de résumé. Vos clients continueront à se confier, et votre marque pourra le dire sans gêne.
FAQ
Questions fréquentes
Repères généraux, à faire valider par votre référent données personnelles ou votre conseil juridique selon votre situation.
C’est une information que le système déduit des échanges sans que l’utilisateur l’ait déclarée : un état de santé à partir d’une question produit, une difficulté financière à partir d’une demande de paiement fractionné, une conviction à partir d’une habitude alimentaire.
Dans l’arrêt C-252/21, la Cour de justice a jugé que le régime protecteur s’applique que l’information révélée soit exacte ou non. Une déduction erronée stockée dans une fiche client pose donc le même problème, avec en prime un risque d’erreur dans la relation client.
C’est possible pour un usage précis et justifié, par exemple un conseil adapté à une allergie déclarée. Le consentement doit être libre, spécifique, éclairé et univoque. L’utilisateur peut le retirer à tout moment. Pour un ciblage publicitaire fondé sur des inférences, cette base est difficile à réunir en pratique.
Pas encore. Le rapport remis le 10 novembre 2026 formule des propositions. Les obligations actuelles découlent du RGPD et de la jurisprudence européenne, qui couvrent déjà une partie des inférences sensibles.
Une analyse d’impact relative à la protection des données est requise lorsque le traitement est susceptible d’engendrer un risque élevé, par exemple un traitement de données sensibles à grande échelle ou un profilage systématique. Votre référent données personnelles vous aidera à trancher.
SOURCES
Sources et pour aller plus loin
Ressources consultées le 17 novembre 2026.
- CJUE, 4 juillet 2023, Meta Platforms e.a., C-252/21
Application de l'article 9 du RGPD aux données qui révèlent indirectement des informations sensibles.
- CNIL : chapitre 2 du RGPD, principes
Texte de l'article 9 sur les catégories particulières de données.
- Kohen Avocats : rapport IA du 10 novembre 2026, ce qui est proposé
Détail de la recommandation n° 17 sur les données déduites des conversations.
- Banque des Territoires : le CIANum s'alarme de la flagornerie des IA génératives
Présentation du rapport et du risque d'inférence de données non confiées.